多周期 MIPS CPU:阶段、控制字与可验证状态
多周期处理器不是把单周期处理器“运行慢五倍”,而是把一条指令的工作分成若干次有边界的状态转移:每个短周期完成一部分组合计算,周期末把中间结果锁存,下一阶段只依赖已经提交的状态。本文重写自 第六次实验报告,并继续沿用上一篇定义的 15 条实验指令。
一、为何拆成多个周期
单周期的时钟必须覆盖 lw 的“取指—读寄存器—地址计算—读存储器—写回”整条路径。多周期设计把最长约束改成各阶段延迟的最大值:
一条指令的总时间不只取决于时钟周期,还取决于周期数 :。因此“多周期一定更快”并不是无条件结论;它只说明短指令不必再占用最长组合路径,实际收益还要扣除阶段寄存器开销与不同指令的周期分布。

| 指令族 | IF | ID | EXE | MEM | WB |
|---|---|---|---|---|---|
j / halt | ✓ | ✓ | — | — | — |
beq / bgtz | ✓ | ✓ | ✓ | — | — |
sw | ✓ | ✓ | ✓ | ✓ | — |
| R 型 / I 型运算 | ✓ | ✓ | ✓ | — | ✓ |
lw | ✓ | ✓ | ✓ | ✓ | ✓ |
这里的阶段不是流水级。任一时刻只执行一条指令;后一条指令必须等前一条回到 IF 才能开始,所以不存在多条指令重叠执行,也没有数据冒险与转发问题。
二、五阶段的状态契约
1. IF:取指并建立顺序后继
IF 用 PC 访问指令存储器,把输出写入指令寄存器(Instruction Register, IR),同时计算 PC+4。周期结束后至少要保证:IR 在后续阶段保持不变,且当前指令的 PC 或 PC+4 可被分支地址计算复用。
2. ID:译码与读寄存器
ID 根据 opcode/funct 生成控制信息,并读取源寄存器。严格的多周期数据通路通常把两个读数锁存到 A、B 寄存器;否则后续阶段仍直接依赖寄存器堆组合输出和当前指令字段。
3. EXE:运算、比较或有效地址
R/I 型运算在此产生 ALU 结果;lw/sw 计算 base + offset;分支比较两个源并计算目标地址。EXE 结束后,运算结果应进入 ALUOut,零标志或比较结果也应在需要时锁存。
4. MEM:唯一允许存储器副作用的阶段
lw 读取数据并写入 Memory Data Register(MDR),sw 在此阶段使能写端口。MemWrite 必须与 stage == MEM 同时成立,避免组合信号在其他阶段短暂变化时误写存储器。
5. WB:唯一允许寄存器副作用的阶段
R/I 型运算把 ALUOut 写回,lw 把 MDR 写回。RegWrite 必须与 stage == WB 同时成立。这样,阶段身份成为状态更新的必要条件,而不仅是波形上的标签。
三、控制字:压缩布线,不替代状态机
原实验把控制信号、寄存器编号、ALU 操作与阶段掩码打包为一条 32 位“仿微指令”。更准确的名称是水平控制字:它不是存放在控制存储器中的完整微程序,而是由当前机器指令组合译码得到的一组控制字段。
| 位段 | 含义 | 位段 | 含义 |
|---|---|---|---|
[31:29] | StageControl: EXE/MEM/WB 掩码 | [28:25] | ALUControl |
[24:20] | 第一读寄存器 | [19:15] | 第二读寄存器 |
[14:10] | 写寄存器 | [9] | 原计划存放零标志,实际未使用 |
[8:6] | Halt / Branch / Jump | [5:3] | MemtoReg / MemWrite / MemRead |
[2:0] | RegWrite / RegDst / ALUSrc |
打包的优点是接口集中、波形易于按十六进制观察;缺点是位号本身没有类型信息。MicroInstruct[4] 与 MicroInstruct[5] 的交换仍然能通过编译,却会把写存储器误接成写回选择。更稳健的 SystemVerilog 可以使用结构体与枚举:
typedef enum logic [4:0] {
    ST_IF  = 5'b10000,
    ST_ID  = 5'b01000,
    ST_EXE = 5'b00100,
    ST_MEM = 5'b00010,
    ST_WB  = 5'b00001
} stage_t;

typedef struct packed {
    logic [2:0] stage_mask;
    logic [3:0] alu_control;
    logic [4:0] read1, read2, write;
    logic jump, branch, halt;
    logic mem_to_reg, mem_write, mem_read;
    logic reg_write, second_read_disable, alu_src_reg;
} control_word_t;
类型不会改变综合后的位数,却能让字段名承担语义,并允许 lint 工具检查遗漏与非法状态。
四、阶段控制器与数据通路

原实验的 Stage 使用 one-hot 编码:10000、01000、00100、00010、00001 分别表示 IF、ID、EXE、MEM、WB。IF 与 ID 固定出现;ID 之后根据三位掩码跳到尚需执行的最早阶段。这个转移规则可以写成:
always_comb begin
    unique case (stage)
        ST_IF:  next_stage = ST_ID;
        ST_ID:  next_stage = need_exe ? ST_EXE :
                              need_mem ? ST_MEM :
                              need_wb  ? ST_WB  : ST_IF;
        ST_EXE: next_stage = need_mem ? ST_MEM :
                              need_wb  ? ST_WB  : ST_IF;
        ST_MEM: next_stage = need_wb ? ST_WB : ST_IF;
        ST_WB:  next_stage = ST_IF;
        default: next_stage = ST_IF;
    endcase
end

always_ff @(posedge clk or posedge reset)
    if (reset) stage <= ST_IF;
    else       stage <= next_stage;
与原代码相比,这里把“计算下一状态”和“提交当前状态”分离,使用复位而非 initial 作为硬件初始化契约,并为非法 one-hot 状态提供恢复路径。
1. PCWriter 的职责
本实验把 PC 选择集中到 PCWriter:IF 默认准备 PC+4,ID 允许 j 选择跳转地址,EXE 允许条件分支选择分支地址。其关键不变量是 PC 只在 IF 边界更新一次;否则 ID/EXE 中组合候选变化可能让同一条指令重复或跳过。
2. 写使能必须与阶段相与
原工程已经对两处关键副作用作了门控:
reg_write_enable = control.reg_write && (stage == ST_WB);
mem_write_enable = control.mem_write && (stage == ST_MEM);
但若 ALU 结果和存储器读数没有分别锁存,WB 仍依赖一条跨越多个周期的组合路径保持稳定。严格实现应加入 IR、A、B、ALUOut 与 MDR;这些寄存器不是形式上的“阶段装饰”,而是阶段契约的物理载体。
五、逐指令验证
冒泡排序仍作为系统级测试。lw → slt → beq → sw 覆盖五阶段指令、比较分支与存储器副作用,j 覆盖 ID 后提前返回,halt 检查停机保持。
halt 所在地址。该结果是端到端证据,还需阶段级断言定位局部错误。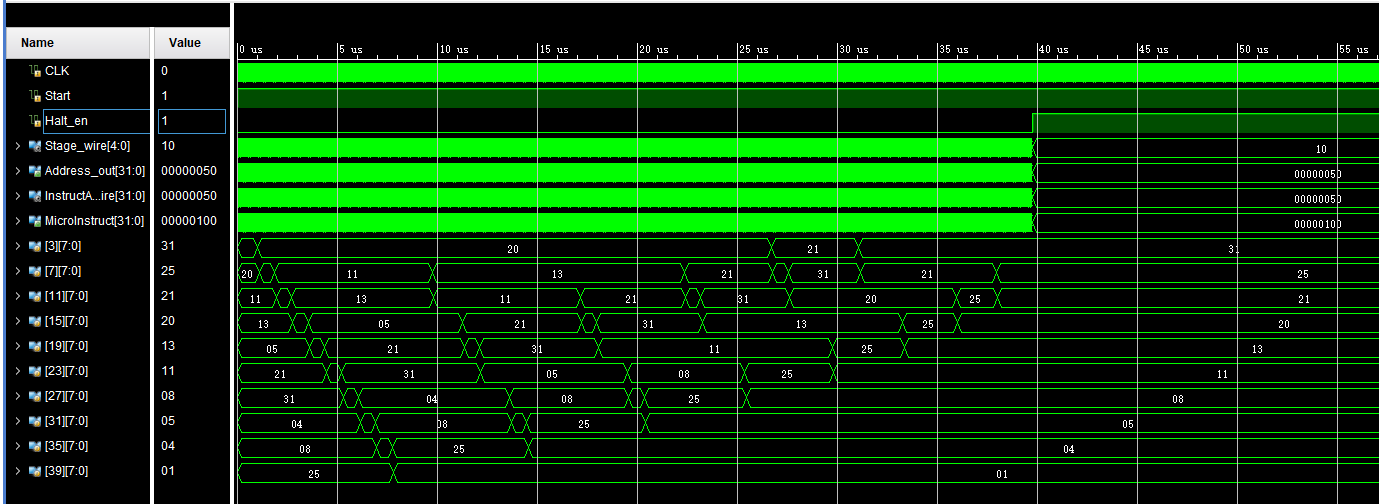
| 指令 | 期望阶段序列 | 关键提交 |
|---|---|---|
j | IF → ID | ID 决定下一 PC;不写寄存器与存储器 |
beq | IF → ID → EXE | EXE 根据比较结果选择下一 PC |
| R/I 运算 | IF → ID → EXE → WB | 仅 WB 写目标寄存器 |
sw | IF → ID → EXE → MEM | 仅 MEM 写数据存储器 |
lw | IF → ID → EXE → MEM → WB | MEM 取数,WB 写目标寄存器 |
适合加入测试平台的断言包括:
assert property (@(posedge clk) mem_write |-> stage == ST_MEM);
assert property (@(posedge clk) reg_write |-> stage == ST_WB);
assert property (@(posedge clk) stage != ST_IF |-> $stable(ir));
assert property (@(posedge clk) halt |=> $stable(pc));
assert property (@(posedge clk) $onehot(stage));
性能验证还应统计各指令类别的动态条数。若它们分别为 ,对应周期数为 2、3、4、4、5,则
只有把这个 CPI 与实现后的 一起测量,才足以比较单周期与多周期的执行时间。
六、原实现到底有多“多周期”
原报告已经诚实指出:模块的组合计算并未被阶段寄存器隔开,控制字在指令变化后立即生成,ALU 与读端口也持续工作;Stage 主要约束 PC、MEM 与 WB 的写入时刻。因此它更接近“单周期组合数据通路 + 多周期提交调度器”。
这个结构在低频 FPGA 教学实验中有现实价值:它最大限度复用单周期工程,并让不同指令拥有不同提交周期数。然而它不能自动获得严格多周期结构应有的较短临界路径,也没有形成可独立验证的阶段边界。若要继续扩展为流水线,必须补齐 IR、A/B、ALUOut、MDR 等寄存器,并重新做时序与冒险分析。
andi/ori 的零扩展、slt 的有符号比较以及 bgtz 的严格大于零判断。阶段化不会修正指令语义;它只改变同一语义被分几次提交。七、结论
从单周期到多周期,真正新增的不是五个英文缩写,而是三组可检查的边界:阶段之间保存什么,哪个阶段拥有哪类副作用,以及控制器如何从当前状态确定下一状态。32 位控制字可以压缩布线,one-hot 状态可以简化译码,但它们都不能替代这些不变量。
本文的数据通路与阶段图使用 circuiteria 重绘,源码与上一篇的 rivet 指令图一并独立保存,便于继续修订而不依赖位图编辑器。